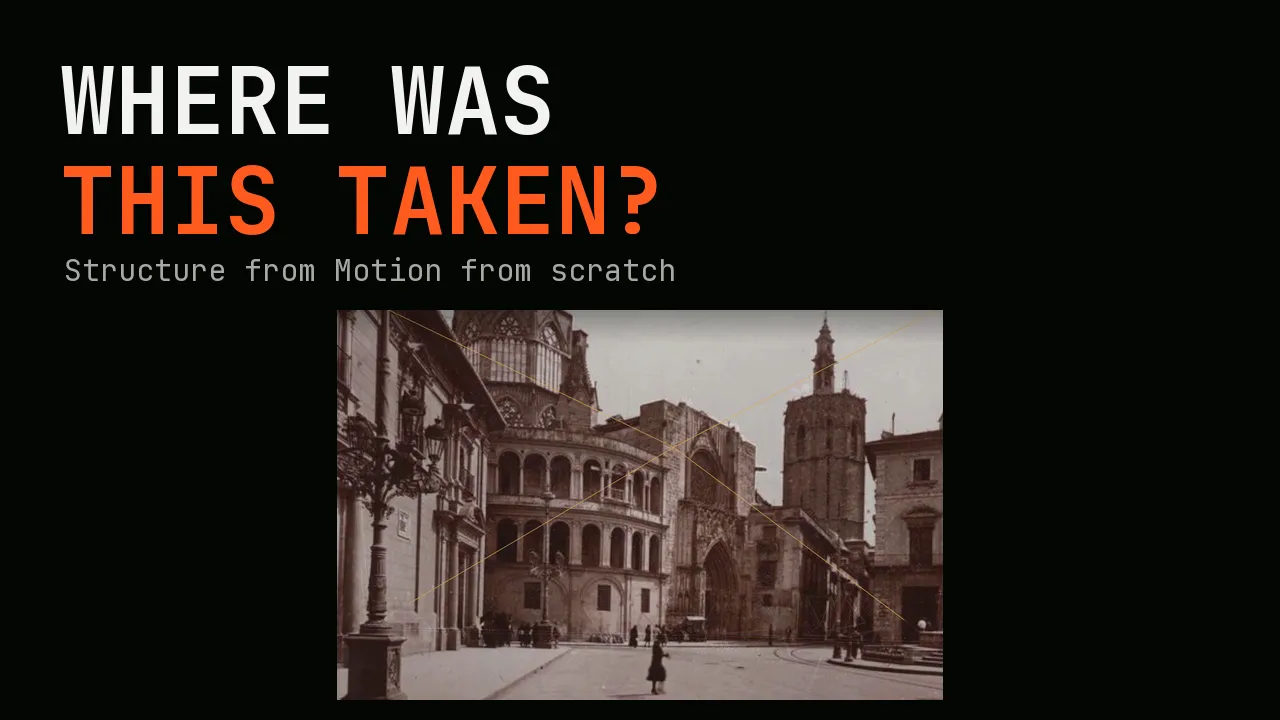
Problema
Detrás de casi cualquier modelo 3D hecho con fotos hay un Structure from Motion: un mapa de un SLAM, una fotogrametría de un edificio, un Gaussian splat. A partir de fotos sueltas, calcula desde dónde se hizo cada una y qué forma tiene en 3D lo que aparece en ellas. La herramienta que usa casi todo el mundo es COLMAP.
Usar COLMAP es fácil. Entender lo que hace por dentro, no tanto. Así que decidí crear desde cero mi propia librería, completa y usable por cualquiera, con tres objetivos:
- Entender el proceso entero con una escena real: la catedral de Valencia desde la Plaza de la Virgen. De la toma de fotos a la calibración y la reconstrucción 3D.
- Verlo en directo: una interfaz interactiva donde ver cómo se construye el modelo, cámara a cámara, mientras se calcula.
- Ponerlo a prueba con una foto histórica de la misma plaza: ¿desde dónde se hizo, con qué cámara y qué ha cambiado desde entonces?
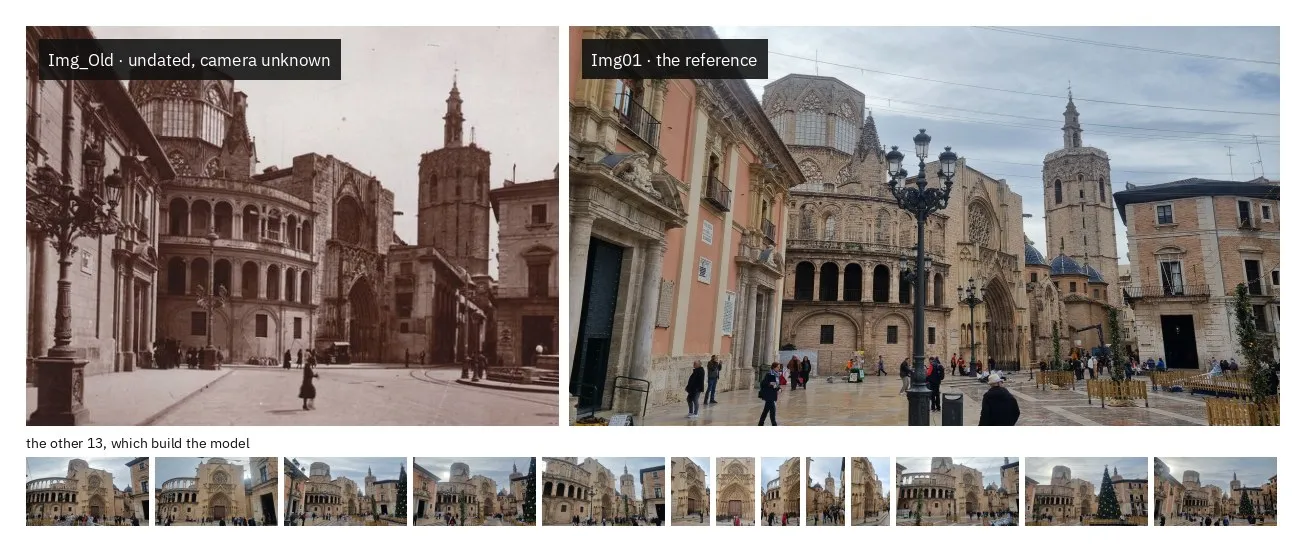
Foto histórica: Archivo Huguet.
Lo último es lo difícil. De la cámara del móvil se sabe todo; de la antigua, nada. No basta con saber desde dónde se hizo: hay que deducir cómo era la cámara, su focal y el centro de la imagen, que además se mueve si la foto está recortada. Hay que colocarla sin que sus errores descoloquen lo ya reconstruido: las 14 cámaras del móvil y sus puntos 3D. Y por si fuera poco, en tanto tiempo cambian la luz y el tono, y eso no puede pasar por un cambio real.
Restricciones
- Medirlo contra la referencia. Cada resultado se compara con COLMAP, ejecutado desde cero sobre las mismas fotos. No comparten nada más: ni los puntos ni los emparejamientos. Si coinciden, es porque los dos han visto la misma plaza.
- Nada de caja negra. El proceso se ve en vivo, cámara a cámara, mientras se calcula. Y verlo no puede costar nada: si el visor se cae, la reconstrucción sigue.
- Fácil de instalar y de usar en lo tuyo. Se instala igual con GPU o sin ella, también con Docker. Y para un proyecto propio basta con traer tus fotos: un comando lo prepara.
Enfoque
Un Structure from Motion hace lo mismo que nuestros dos ojos, pero con muchas fotos. Busca puntos que se repiten de una foto a otra: una esquina, el borde de una ventana. Si sabe dónde cae un mismo punto en dos fotos, puede calcular a la vez dónde está en 3D y desde dónde se hizo cada foto. Después, cada foto nueva se coloca contra los puntos que ya hay y aporta los suyos. Así, foto a foto, crece el modelo.
Para ello construí sfmkit, una librería pensada para que cada paso del proceso se pueda ejecutar por separado o todos seguidos, cada uno con su propio comando desde la terminal (su CLI). Cada paso recoge lo que dejó el anterior y guarda lo suyo, así que el flujo queda bien definido y permite parar en cualquier punto, mirar qué ha salido, cambiar un ajuste y repetir solo ese paso, sin rehacer todo lo anterior. (El esquema de abajo resume el flujo; la documentación lo cuenta paso a paso.)
Emparejamiento de las fotos
Lo primero es encontrar los mismos puntos en fotos distintas. Para eso uso dos redes neuronales conocidas: SuperPoint marca en cada foto los puntos que se pueden reconocer, y LightGlue decide cuál de una foto es cuál en la otra. Pero no todas las parejas son buenas: en una fachada se repiten ventanas y arcos, y es fácil confundirlos.
Para separarlas hay una regla geométrica. Un píxel de una foto no es un punto del espacio: es un rayo, la recta que sale de la cámara y atraviesa ese píxel. El punto real está en algún lugar de ese rayo, más cerca o más lejos. Visto desde la otra cámara, ese rayo se ve como una línea, la línea epipolar, y la pareja buena tiene que caer sobre ella. Toda esa relación entre las dos fotos cabe en una sola matriz de 3×3, la matriz fundamental (F). No depende de qué haya en la escena, solo de cómo están colocadas las dos cámaras, y por eso se puede estimar a partir de las propias parejas: con RANSAC, probando grupos de ocho al azar hasta dar con la F que más parejas cumplen. Cada pareja se juzga por lo lejos que cae de su línea: a más de 4 píxeles, se descarta. Lo que sobrevive son coincidencias en las que se puede confiar, y con ellas empieza la reconstrucción.
Reconstrucción de la escena
Con las parejas limpias, la escena se construye poco a poco. Primero se elige un par inicial, y no vale cualquiera: la pareja con más coincidencias suele ser la de dos fotos casi iguales, y entre dos vistas tan parecidas la profundidad sale mal. Así que gana la que tiene más coincidencias con ángulo suficiente entre las dos cámaras. Su matriz fundamental (F), la que ya separó las parejas buenas de las malas, se convierte en la matriz esencial (E) en cuanto se conoce la cámara del móvil, su calibración (K). Y de la E sale cómo está colocada una cámara respecto a la otra. Hay cuatro soluciones posibles, pero solo una deja la escena delante de las dos.
Con las dos primeras cámaras colocadas, cada pareja de puntos da dos rayos, y donde se cruzan con suficiente ángulo está el punto en 3D: es la triangulación. Después, la escena crece una foto cada vez, y cada una se coloca a partir de los puntos 3D que ya reconoce: sabiendo dónde aparecen en ella, se busca la cámara que los vería así (el problema PnP, otra vez con RANSAC). Si no encaja, se queda fuera para no contagiar su error; si encaja, aporta sus puntos nuevos. Pero cada cámara hereda el pequeño error de los puntos sobre los que se coloca, y foto a foto ese error se acumula. Por eso, tras cada foto se refinan a la vez todas las cámaras y todos los puntos, para que cada punto, proyectado en cada foto, quede lo más cerca posible de donde realmente aparece. Es el bundle adjustment, que minimiza ese error de reproyección y deja cámaras y puntos en su sitio. Como el resto de sfmkit, está escrito desde cero.
Localización de la foto antigua
Una vez reconstruida la escena, se puede localizar la foto antigua sobre ella. Para ello se empareja con una foto de hoy hecha desde un sitio parecido, que ya forma parte del modelo: detrás de cada uno de sus puntos hay un punto 3D de la plaza, así que cada pareja dice «este píxel de la foto antigua vio este punto de la plaza». Es casi el PnP de antes, con una diferencia importante: de la cámara antigua no se sabe nada, ni su focal ni dónde cae el centro de la imagen. Así que no basta con buscar su posición; hay que despejar su matriz de proyección (P) completa: se pasa de las seis incógnitas del PnP (tres de giro y tres de posición) a once, que incluyen también la propia cámara. Con seis parejas punto 3D–píxel ya se puede resolver como un sistema lineal, usando la DLT. Entre cientos de parejas, RANSAC prueba grupos de seis al azar y se queda con la P que más parejas respetan. Después, la cámara se refina minimizando su error de reproyección, como en el bundle adjustment pero con los puntos de la plaza fijos.
Detección de cambios
Para ver qué ha cambiado entre la foto antigua y la actualidad, primero hay que superponerlas. Con las parejas entre las dos fotos se estima, otra vez con RANSAC, una homografía: la deformación que lleva la foto antigua sobre la de hoy, exacta para un plano y suficiente para una fachada. Restarlas sin más no sirve, porque la antigua tiene otra exposición y otro tono, y toda la imagen saldría como cambio. Así que, en cada píxel, se comparan dos medidas que no dependen del brillo ni del contraste de la foto. La primera es la orientación del gradiente, la dirección de los bordes, que solo cuenta donde las dos fotos tienen borde. La segunda es la intensidad normalizada localmente: el brillo de cada píxel menos la media de su entorno, dividido por la variación de ese entorno, de modo que una foto entera más oscura o más plana no cambia nada. Ambas se combinan en una puntuación de 0 a 1; lo que supera un umbral se marca como cambio, y se eliminan las manchas demasiado pequeñas para ser reales.
Resultado
La reconstrucción coloca las 14 fotos de la plaza y 2 830 puntos 3D. Para saber si es correcta, la comparo con la de COLMAP: alineo los dos modelos y mido cuánto difiere la orientación de cada cámara entre uno y otro. De media, 0,30°, y ninguna pasa de 1,4°. Los dos modelos se pueden comparar en el visor de sfmkit, en el mismo marco: al pulsar una cámara, su foto se superpone sobre los puntos, y si los bordes del edificio caen sobre ellos, no hace falta creerse ningún número.
Panel: capas, cámaras y datos
Pulsa y mantén para girar el modelo
Progresión de cámaras · usa ← →
Mejor a pantalla completa
Con el modelo reconstruido, la localización de la foto antigua sobre él sitúa su cámara a solo 0,60° de la que da COLMAP, con un error de reproyección de 1,9 píxeles. Pero no solo dice dónde estaba: también cómo era la cámara. Tenía un campo de visión de 53°, bastante más cerrado que los 67° del móvil, y el centro de su imagen está 119 píxeles por debajo del medio. Puede que la copia esté recortada, o que el fotógrafo descentrara el objetivo hacia arriba, como se hacía con las cámaras de fuelle para fotografiar edificios sin inclinar la cámara. Las dos cosas dejan la misma huella, y el cálculo la encuentra.
La detección de cambios cierra el último objetivo. La foto antigua se superpone sobre la de hoy, deformada hasta que las dos fachadas encajan, y se compara su estructura zona a zona: donde la piedra coincide, la plaza es la misma; lo que no encaja es lo que ha cambiado. Las farolas se han movido, ha desaparecido un edificio junto a la catedral y la galería da ahora a un patio. Hay gente en las dos fotos, pero nunca en el mismo sitio.
Stack y entregables
- Librería sfmkit Toda la geometría en Python y NumPy: emparejamiento verificado, reconstrucción incremental, localización y un bundle adjustment propio.
- Evaluación frente a COLMAP Ejecuta COLMAP desde cero sobre las mismas fotos, alinea los dos modelos y mide el error de cada cámara.
- CLI Diez pasos, cada uno un comando.
sfmkit runlos lanza todos, ysfmkit newprepara un proyecto con tus propias fotos. - Visor, sfmview Los dos modelos en el navegador, en el mismo marco, y la reconstrucción dibujándose en directo mientras se calcula.
- Proyecto de Valencia Las fotos, la configuración y una ejecución de referencia, que la CI repite en cada cambio: falla si alguna cámara se aleja más de 0,02°.
- Documentación y despliegue Tutorial, guía de cada paso y resultados; imágenes Docker publicadas automáticamente. Código abierto, licencia MIT.
Dónde encaja esto
Structure from Motion es una de las bases de la visión por computador. Usar después técnicas más avanzadas, como Gaussian splatting, un SLAM o capas de deep learning para la inteligencia espacial, pasa por entender bien qué está pasando desde el punto de vista geométrico: cómo se relacionan dos vistas, de dónde sale cada cámara y por qué un modelo se deforma. Este proyecto fue mi forma de dominarlo desde cero.
Con esa base puedo entrar en un sistema de visión 3D ya montado y entender por qué una reconstrucción sale mal o una cámara se pierde. Muchas veces el problema no está en la red más moderna, sino en la geometría que tiene debajo, y ahí es donde sé mirar.